Ceci est un texte traduit automatiquement qui peut contenir des erreurs !
Sur les tâches de cryptographie
Ces tâches sont structurées un peu différemment des autres tâches sur Piggy, nous sommes curieux de savoir ce que vous préférez ! 😎
Il y aura d’abord une partie d’informations pour commencer sur les thèmes, puis il y aura quelques tâches ensuite !
Les « niveaux » dans cette tâche ne sont pas tout à fait comme les niveaux précédents, ici les choses sont plus divisées par thème.
Partie 1 – Cryptage et décryptage des chifres mono-alphabétiques
Aller directement aux exercices
Qu’est-ce qu’un « chiffrement » ?
Avez-vous déjà eu envie d’écrire un message secret à un ami, afin que personne d’autre ne puisse le comprendre ? Dans ce cas, il vous faut un cipher, ou une méthode de cryptage ! Un chiffre est simplement une technique qui transforme du texte courant en « code » en remplaçant des caractères (souvent des lettres) par d’autres caractères. Le résultat semble absurde pour ceux qui ignorent comment fonctionne le code. L’idée est que seules les personnes connaissant la clé (la règle permettant de remplacer les lettres) peuvent rendre le code compréhensible à nouveau. En d’autres termes : les chiffres rendent possible l’envoi de messages secrets, qu’il s’agisse du jeu de langage secret de l’enfance ou d’espions réels envoyant des messages chiffrés. 😄
Le saviez-vous ?
Le mot « chiffre » provient en fait d’un mot arabe : le mot sifr, qui signifie « zéro ». Peut-être parce que le code secret ressemblait à rien (aucun sens !) pour ceux qui ne parvenaient pas à le déchiffrer !
Il existe de nombreux types de chiffrements – certains utilisent des chiffres, d’autres des symboles, et le chiffrement informatique moderne utilise des algorithmes très complexes. Ces algorithmes complexes nécessitent des mathématiques très complexes, alors regardons d’abord quelques algorithmes plus simples !
Chiffres monalpha bétiques
Commençons par examiner certaines des méthodes de codage les plus simples (et les plus anciennes) : les chiffres monalphabetiques.
Monalphabétique peut sembler un mot difficile, mais nous pouvons le décomposer : « mono » signifie « un », et alphabétique concerne l’alphabet.
Ainsi, les chiffres monalphabetiques sont des codes dans lesquels on utilise une seule « clé d’alphabetic cryptographique » pour tout le message. Cela signifie que chaque lettre du texte original est toujours remplacée par la même lettre dans tout le message chiffré.
Par exemple, si vous avez décidé que A doit être échangé avec X, alors tous les A du texte seront convertis en X.
Chiffre de César
L’exemple classique d’un chiffrement monalphabetique est le chiffre de César (nommé ainsi d’après Jules César). Il s’agit essentiellement d’une règle consistant à « décaler » toutes les lettres d’un certain nombre de positions dans l’alphabet. On dit que César lui-même utilisait un décalage de 3 lettres dans ses messages secrets. Le principe fonctionne comme suit : A devient D, B devient E, C devient F, et ainsi de suite tout au long de l’alphabet. (Quand on passe Z, on repart sur A.) Un message composé de ABC deviendrait donc DEF si nous utilisons la méthode de César.
Personne ne s’attend à un message en chiffre de César ?
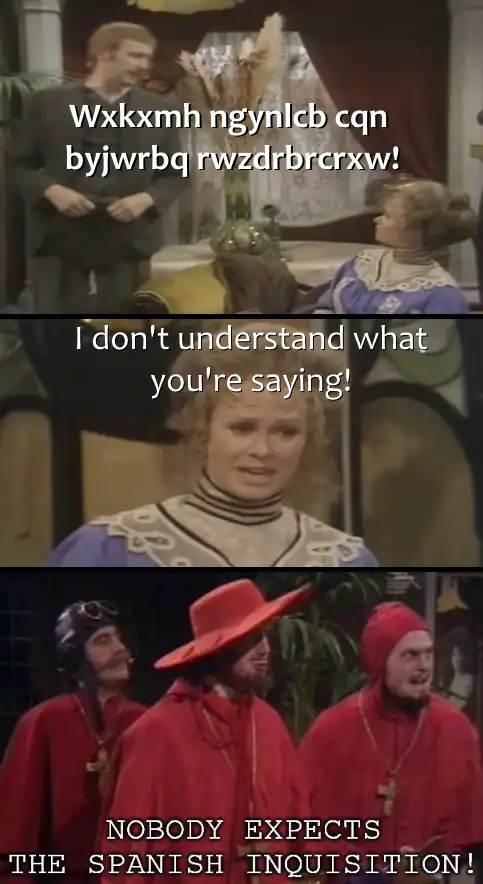
Comment fonctionne le chiffrement de César en pratique :
- Choisissez une clé : Déterminez un nombre secret (par exemple 3) qui indique de combien de places vous devez décaler chaque lettre.
- Remplacez chaque lettre : Pour chaque lettre du message original, trouvez la lettre qui se trouve autant de places après elle dans l’alphabet (pour une clé de 3, A devient D, B devient E, etc. – n’oubliez pas de revenir à A après Z si nécessaire). Vous pouvez également inclure Æ, Ø et Å, mais cela devient un peu plus compliqué.
- Message chiffré : Remplacez les lettres et écrivez le nouveau message avec les lettres « décalées ». Et voilà – vous avez un texte illisible et secret que seuls ceux qui connaissent la clé peuvent comprendre !
- Pour déchiffrer (c’est-à-dire le remettre sous forme de texte lisible), il suffit de faire le décalage inverse. Si vous connaissez la clé (par exemple 3), il est tout aussi facile de lire le message en décalant les lettres de 3 places en arrière dans l’alphabet.
Sécurité ?
Ces codes ne sont pas très sécurisés à long terme. Étant donné que le motif (la substitution) est fixe, une personne assez patiente ou utilisant quelques astuces intelligentes peut rapidement révéler le secret. Par exemple, il n’y a qu’un petit nombre de décalages possibles dans la chiffrement de César, autant que les lettres de l’alphabet, donc n’importe qui peut essayer tous jusqu’à ce que le message ait un sens – ou utiliser des fréquences de lettres pour deviner. En d’autres termes, mieux vaut éviter d’utiliser le chiffrement de César pour des notes de journal ultra-confidentielles ou des secrets d’État 😉.
Les chiffres monoalphabétiques sont un excellent moyen d’apprendre le principe derrière le chiffrement. Ils sont simples et montrent comment nous pouvons utiliser une règle simple (une clé) pour transformer un texte compréhensible en quelque chose de mystérieux et incompréhensible – et vice versa. Alors, la prochaine fois que vous voudrez envoyer un message secret à un ami, vous pouvez utiliser le chiffre de César ! Peut-être pourriez-vous créer votre propre variante de l’alphabet secret de César ? 🔐✨
Tâches
Langage de programmation ?
Comme avant, n’hésitez pas à utiliser le langage de programmation de votre choix ! Les exemples ici seront en Python.
 Exercice 1.1 - Chiffre de César - Cryptage
Maintenant, nous allons réellement écrire du code ! Nous allons commencer simplement en créant le cryptage, basé sur la théorie, cela devrait être assez simple.
Implémentez le cryptage avec le Chiffre de César en utilisant une fonction qui prend en entrée un texte et un nombre qui est la “clé”, c’est-à-dire de combien l’alphabet doit être tourné.
Conseils sur la méthode à suivre.
- Créez une fonction nommée
caesarqui prend le texte à chiffrer comme paramètre ainsi qu’un « décalage », c’est-à-dire le nombre de positions dans l’alphabet que le texte doit être déplacé. - Parcourez le texte lettre par lettre.
- Nous ne voulons pas « décaler » d’autres caractères que les lettres : découvrez comment vérifier si un caractère dans le texte est une lettre.
- Nous devons « faire pivoter » la lettre de n positions, ce qui signifie que nous devons ajouter cette rotation : découvrez comment convertir le texte en nombres afin d’appliquer le décalage. Indice : la fonction
ord(). - Rappel ! Vous obtiendrez différentes valeurs selon que vous avez des minuscules ou des majuscules. Consultez le Tableau ASCII.
- Une fois que vous avez une valeur, il suffit simplement d’additionner la valeur de n. Mais que se passe-t-il si vous êtes à la fin de l’alphabet ? Vous n’aurez que du charabia après la lettre Z. Comment corriger cela ? Cela nécessite un peu de réflexion.
Corriger le chiffrement.
Pour corriger complètement le chiffrement, un peu de réflexion est nécessaire.
- La première étape consiste à penser à utiliser l’opérateur modulo,
%. - Puisque l’alphabet (en anglais) est composé de 26 lettres, nous pouvons prendre modulo avec
26. - Mais cela ne fonctionne pas entièrement, voyez-vous pourquoi ?
- Essayez d’imprimer (
print) la valeur d’un caractère avecord(); qu’est-ce que vous obtenez ? - Pour
a, vous obtenez 97. Si vous prenez le modulo 26 de ce nombre, vous obtenez 19. N’oubliez pas que le modulo donnera toujours une réponse comprise entre 0 et le diviseur. - Cela peut être corrigé en stockant les valeurs initiales des majuscules et minuscules, en soustrayant cette valeur de la lettre, puis en prenant le modulo. On a alors :
(ord(lettre) - ord('a')) % 26 - Pour récupérer la bonne lettre, il suffit de réajouter la valeur initiale.
- Après tout cela, vous pouvez enfin convertir le nombre en lettre à nouveau. Vous pouvez utiliser la fonction
chr(). - Maintenant, vous pouvez enfin ajouter la lettre au résultat et retourner le texte chiffré !
Solution :
def caesar_cipher(text, shift):
    result = ""
    for char in text:
        if char.isalpha():
        # determine the starting point based on uppercase and lowercase letters
        start = ord('A') if char.isupper() else ord('a')
        # The difficult shift calculation
        result += chr((ord(char) - start + shift) % 26 + start)
    else:
        result += char
    return result
 Exercice 1.2 - Déchiffrement du chiffre de César
Le déchiffrement consiste simplement à effectuer l’opération inverse de celle utilisée pour le chiffrement. On soustrait le décalage au lieu de l’ajouter.
Conseils sur la méthode à adopter.
Utilisez la fonction que vous avez créée pour l’exercice 1 à cet effet. Prenez simplement la même fonction, mais en sens inverse. Vous pouvez le faire en transformant le décalage avec 26 - shift.
Solution :
def caesar_decrypt(text, shift):
    return caesar_cipher(text, 26 - shift)
Autres Chiffres Monoalphabétiques (ex. Atbash)
Il existe d’autres chiffres monoalphabétiques aussi ! L’un des plus simples est celui qui s’appelle le Chiffre “Atbash”.
Comment fonctionne Atbash ?
C’est très simple, au lieu d’une rotation, les lettres sont mappées à l’alphabet inverse. Voici un tableau montrant le mappage :
| a | b | c | d | e | f | g | h | i | j | k | l | m | n | o | p | q | r | s | t | u | v | w | x | y | z |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| z | y | x | w | v | u | t | s | r | q | p | o | n | m | l | k | j | i | h | g | f | e | d | c | b | a |
Tâche 1.3 - Chiffré Atbash : chiffrement et déchiffrement
L’aspect intéressant d’Atbash est que le chiffrement étant une transformation biunivoque (1 pour 1), il fonctionne directement à l’envers. Autrement dit, si vous avez créé le chiffrement, vous avez également, automatiquement, créé le déchiffrement.
Comment peut-on le faire dans la pratique ?
Vous pouvez soit soustraire la lettre par rapport au Z, soit créer une table « Look-up ». Autrement dit, il s’agit d’un tableau ou d’une liste associative contenant toutes les lettres de a à z et ce qu’elles doivent devenir. Cela peut être une bonne solution si vous souhaitez créer un autre type de chiffrement.
- Implémentation de table de recherche.
lettres = {
    'a': 'z'
    'b': 'y'
    'c': 'x'
    'd': 'w'
    # ... ajouter le reste des lettres vers le bas
}
À l’aide de ce tableau, vous pouvez parcourir lettre par lettre, puis récupérer la valeur pour chaque lettre à partir du tableau de recherche, et enfin l’afficher. Que devez-vous faire pour les majuscules et les minuscules ?
Partie 2 - Cryptanalyse des chiffres mono-alphabétiques
Dans cette partie, vous devez essayer de créer un algorithme pour « craquer » un chiffre César, c’est-à-dire prendre un texte chiffré, puis obtenir le texte original sans connaître la clé.
Cela peut être fait plus ou moins manuellement, ou bien vous pouvez essayer d’utiliser une simple « cryptanalyse ». C’est un concept que nous examinerons plus en détail plus tard, mais pour l’instant, nous ne ferons qu’examiner l’une des méthodes les plus simples : l’analyse de fréquence. Vous pouvez lire davantage à ce sujet ici : Analyse de fréquence ou ici Wikipédia - Analyse de fréquence.
Cette méthode peut être utilisée au-delà du seul chiffre César ; elle s’applique également aux algorithmes plus complexes, mais le chiffre César est si simple que l’analyse de fréquence y est triviale.
Comment fonctionne l’analyse de fréquence ?
L’analyse de fréquence est, comme son nom l’indique, une méthode pour vérifier la fréquence des lettres dans un texte. Pourquoi cela peut-il être utile ? Imaginez que vous ayez un long texte, prenons ici un texte anglais, tiré de Wikipedia - frequency analysis :
In cryptanalysis, frequency analysis is the study of the frequency of letters or groups of letters in a ciphertext. The method is used as an aid to breaking classical ciphers.

Frequency analysis is based on the fact that, in any given stretch of written language, certain letters and combinations of letters occur with varying frequencies. Moreover, there is a characteristic distribution of letters that is roughly the same for almost all samples of that language. For instance, given a section of English language, E, T, A and O are the most common, while Z, Q, X and J are rare. Likewise, TH, ER, ON, and AN are the most common pairs of letters termed bigrams or digraphs), and SS, EE, TT, and FF are the most common repeats. The nonsense phrase ETAOIN SHRDLU represents the 12 most frequent letters in typical English language text.

In some ciphers, such properties of the natural language plaintext are preserved in the ciphertext, and these patterns have the potential to be exploited in a ciphertext-only attack.
Si nous transformons ce texte en utilisant le chiffre de César (en supprimant également les virgules, les espaces et d’autres caractères spéciaux), nous obtenons le texte chiffré suivant :
xcrgneipcpanhxhugtfjtcrnpcpanhxhxhiwthijsnduiwtugtfjtcrnduatiitghdgvgdjehduatiitghxcprxewtgitmiiwtbtiwdsxhjhtsphpcpxsidqgtpzxcvraphhxrparxewtghugtfjtcrnpcpanhxhxhqphtsdciwtupriiwpixcpcnvxktchigtirwdulgxiitcapcvjpvtrtgipxcatiitghpcsrdbqxcpixdchduatiitghdrrjglxiwkpgnxcvugtfjtcrxthbdgtdktgiwtgtxhprwpgpritgxhixrsxhigxqjixdcduatiitghiwpixhgdjvwaniwthpbtudgpabdhipaahpbeathduiwpiapcvjpvtudgxchipcrtvxktcphtrixdcdutcvaxhwapcvjpvttippcsdpgtiwtbdhirdbbdclwxatofmpcsypgtgpgtaxztlxhtiwtgdcpcspcpgtiwtbdhirdbbdcepxghduatiitghitgbtsqxvgpbhdgsxvgpewhpcshhttiipcsuupgtiwtbdhirdbbdcgtetpihiwtcdchtchtewgphttipdxchwgsajgtegthtcihiwtbdhiugtfjtciatiitghxcinexrpatcvaxhwapcvjpvtitmixchdbtrxewtghhjrwegdetgixthduiwtcpijgpaapcvjpvteapxcitmipgtegthtgktsxciwtrxewtgitmipcsiwthtepiitgchwpktiwteditcixpaidqttmeadxitsxcprxewtgitmidcanpiiprz
Ce texte semble impossible à « craquer », mais grâce à l’« analyse de fréquence », c’est non seulement possible, mais même simple.
Regardez la figure suivante :
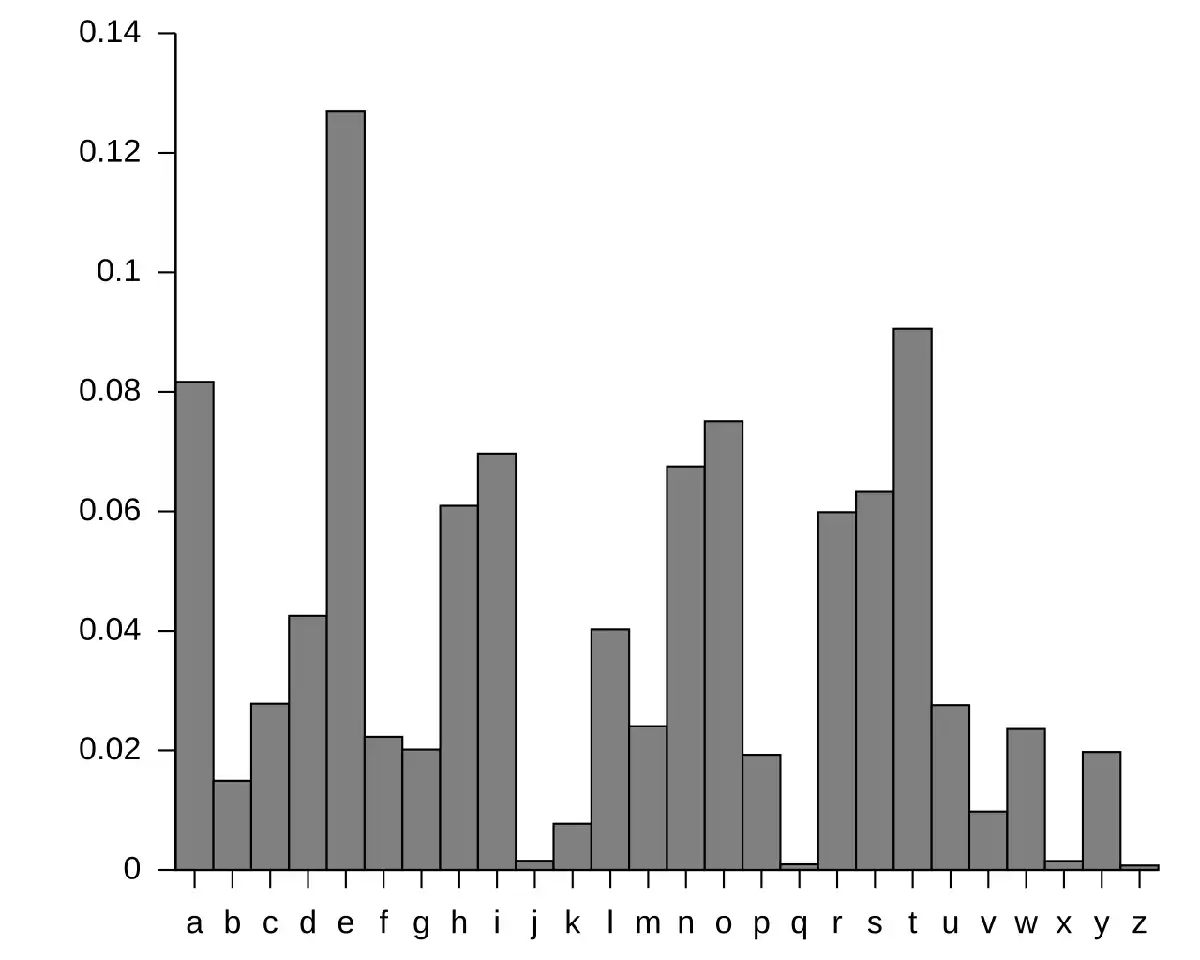
C’est une figure montrant la distribution des lettres en anglais. On peut y voir que la lettre E est la plus fréquente, suivie de T, A et O.
Cela peut être converti en un tableau puis utilisé pour compter et analyser un texte chiffré donné afin de le « craquer ». Dans les exercices ci-dessous, vous devez créer un programme capable de « craquer » les chiffres de César tout seul. Il est vrai que le chiffre de César est si simple que vous pouvez vérifier manuellement toutes les 26 possibilités possibles, mais ici nous devons trouver la solution, entièrement automatiquement.
Exercice 2.1 - Créer un tableau de fréquences
Dans un fichier Python, créez une table des fréquences des lettres de la langue anglaise. Vous pouvez essayer de la trouver vous-même, mais si cela ne vous tente pas, nous le comprenons !
Si vous tenez absolument à la trouver vous-même, vous pouvez procéder comme dans l’Exercice 2.2, mais sur un très grand texte.
Fréquence des lettres en anglais (Réponse)
english_letter_frequency = {
    'E': 12.70,
    'T': 9.06,
    'A': 8.17,
    'O': 7.51,
    'I': 6.97,
    'N': 6.75,
    'S': 6.33,
    'H': 6.09,
    'R': 5.99,
    'D': 4.25,
    'L': 4.03,
    'C': 2.78,
    'U': 2.76,
    'M': 2.41,
    'W': 2.36,
    'F': 2.23,
    'G': 2.02,
    'Y': 1.97,
    'P': 1.93,
    'B': 1.29,
    'V': 0.98,
    'K': 0.77,
    'J': 0.15,
    'X': 0.15,
    'Q': 0.10,
    'Z': 0.07
}
Exercice 2.2 - Compter la fréquence des lettres dans un texte
Maintenant, nous allons créer un algorithme qui trouvera la fréquence des lettres dans un texte donné.
Conseils pour l’avancement
- Commencez par une fonction qui prend un texte en entrée (peut être n’importe quoi).
- Dans la fonction, créez un “dictionary” (Python Dictionaries), avec des entrées pour chaque lettre de l’alphabet, définies à
0. ({'A' = 0, 'B' = 0, 'C' = 0, ..., 'Z' = 0}) - Parcourez tout le texte et comptez chaque lettre (incrémentez de 1 dans l’entrée correspondante du dictionnaire). Ici, vous devriez probablement ignorer les caractères qui ne sont pas des lettres, pensez aussi aux majuscules et minuscules.
- Tenez compte du nombre total de lettres qui ont été comptées.
- Une fois que vous avez fini de compter, divisez
/chaque valeur dans le tableau par la longueur du texte puis multipliez par 100, cela vous donnera une fréquence en pourcentage. (Bien sûr, vous pouvez également laisser votre tableau entre 0 et 1). - Vous devez maintenant avoir un tableau de fréquences pour le texte.
Exercice 2.3 - Comparer la fréquence d’un texte avec la vraie fréquence
Une fois que vous avez trouvé la fréquence de toutes les lettres dans le texte, vous pouvez créer une fonction qui trouve l‘“écart”. Hein ? Qu’est-ce que cela signifie ?!
Vous pouvez imaginer que la fréquence d’une lettre, par exemple E, dans le texte sera un nombre. Vous pouvez trouver l‘“écart” entre cette valeur et la fréquence réelle, qui est 12.70. Exemple : La fréquence est 9.63, quel est l’écart ? L’écart sera la valeur absolue (les nombres négatifs deviennent positifs) entre ces deux valeurs : \(12.70 - 9.63 = 3.07\).
Créez une fonction qui parcourt chacune des lettres pour trouver l’écart. Additionnez ensuite tous les écarts pour obtenir un écart « total ».
Fonction mathématique ?
Si vous voulez savoir à quoi ressemble la fonction mathématique pour celle-ci, elle est comme suit :
\(\sum_{n=0}^{N} \lvert a - b\rvert\)
Conseils sur la méthode
- Utilisez une boucle
forpour parcourir tout le tableau de fréquences. - Pour chaque lettre dans le tableau des fréquences, trouvez la valeur absolue par rapport à la fréquence réelle. Utilisez la fonction
abs()en Python pour cela. - Additionnez toutes les valeurs, vous obtiendrez ainsi un résultat final.
 Exercice 2.4 – « Cracker » les chiffres de César
Maintenant, nous allons enfin assembler tout ce que nous avons fait jusqu’à présent ! Nous allons maintenant « cracker » un chiffre de César.
Écrivez un programme qui « cracke » un chiffre de César ! Sans intervention utilisateur, vous devez pouvoir insérer un texte chiffré pour obtenir le texte déchiffré sans avoir besoin d’une clé.
Test data
Voici quelques données de test que vous pouvez utiliser, que pensez-vous de celles-ci ?
| Test-data |
|---|
cqrbvnbbjpnrbjenahbnlancxwnqxynoduuhhxdjanjkuncxmnlxmnrclxvyuncnuhjwmqnanjanbxvnfxamboaxvxdaojexarcnsnmrqnuuxcqnanrcbxenajwjtrwrqjencqnqrpqpaxdwmhxdfnanarpqccqnwnpxcrjcrxwbfnanbqxac |
lsaizivxlmwqiwwekimwuymxiwlsvxwsmxqmklxrsxasvoewibtigxihlsaizivmjmxhsiwksshnsf |
bmtxymjwjsfdfsxbjwrjxyfsifsizsktqidtzwxjqkqtslqnajymjpnslgfwsfwitmjdtzhtrjrtxyhfwjkzqqdzutsdtzwmtzwynxstbxywzhpybjqajljyymjjytgjikwfshnxhtktwymnxwjqnjkrzhmymfspxynxgnyyjwhtqifsinfrxnhpfymjfwymfajdtzmfivznjylzfwistyfrtzxjxynwwnslbjqqlttisnlmynkdtzitrjjymtwfyntfsirfwhjqqzxymjwnafqxtkrdbfyhmgniymjrrfpjmfxyj |
zwkyvivrivrepzuzfkjzekyviffdnzcckyvpgcvrjvjkreulgjrzukyvjritrjkztkvrtyvirwkvircfexjzcvetvfevwivjydreifjvkfyzjwvvkefnkyvedzjkvinypufpfltfejzuvipflijvcwrezuzfkzehlzivukyvkvrtyvinzkyrjevvinvccrtklrccpzufekjrzukyvjkluvekslkzyrkvkfjvvpfljkreuzexlgkyvivrccsppflijvcw |
uwwilxchaniuffehiqhfuqmizupcuncihnbylycmhiqusuvyymbiofxvyuvfynizfscnmqchamulyniimguffniayncnmzunfcnnfyvixsizznbyaliohxnbyvyyizwiolmyzfcymuhsqusvywuomyvyymxihnwulyqbunboguhmnbchecmcgjimmcvfysyffiqvfuwesyffiqvfuwesyffiqvfuwesyffiqvfuweiibvfuweuhxsyffiqfynmmbueycnojufcnnfyvullsvlyuezumncmlyuxswigcha |
Conseils de méthode
- Commencez par créer une fonction qui prend du texte en entrée.
- Utilisez la fonction de déchiffrement pour les chifres de César avec rotation N sur le texte, N commence à 0.
- Créez un tableau des fréquences du résultat
- Déterminez l’écart entre le résultat et le tableau des fréances réel
- Soit : a) suivez l’écart dans une liste, soit b) conservez la plus petite valeur et la rotation (ce sera la clé)
- Augmentez la rotation de 1 et répétez les étapes 2 à 6 jusqu’à ce que N atteigne 26 (rotation complète).
- Renvoyez le texte déchiffré, c’est-à-dire que la distance minimale est la bonne clé.