Dies ist ein maschinell übersetzter Text, der Fehler enthalten kann!
Über die Krypto-Aufgaben
Diese Aufgaben sind etwas anders strukturiert als die anderen auf Piggy – ich bin mir nicht sicher, was ihr bevorzugt! 😎
Zuerst gibt es eine Reihe von Informationen zum Einstieg in die Themen, danach folgen einige Aufgaben!
Die „Level“ in dieser Aufgabe sind nicht ganz wie die vorherigen Level, hier ist alles eher nach Themen gegliedert.
Teil 1 – Verschlüsselung und Entschlüsselung monoalphabetischer Chiffren
Springe direkt zu den Aufgaben
Was ist ein „Chiffre“?
Hast du je Lust gehabt, eine geheime Nachricht an einen Freund zu schreiben, so dass niemand anderes sie verstehen kann? Dann brauchst du ein Chiffre! Eine Chiffre ist einfach eine Methode, die normalen Text in „Code“ umwandelt, indem Zeichen (oft Buchstaben) durch andere Zeichen ersetzt werden. Das Ergebnis sieht für diejenigen aus wie Unsinn, die nicht wissen, wie der Code funktioniert. Der Punkt ist, dass nur diejenigen, die den Schlüssel (die Regel zum Ersetzen der Buchstaben) kennen, den Code wieder verständlich machen können. Mit anderen Worten: Chiffren ermöglichen geheime Nachrichten, sei es das Spiel mit einer geheimen Sprache in der Kindheit oder echte Spione, die verschlüsselte Meldungen senden. 😄
Wusstest du?
Das Wort “Chiffre” stammt tatsächlich von einem arabischen Wort ab: dem Wort Sifr, was “Null” bedeutet. Vielleicht weil der geheime Code so aussah wie nichts (kein Sinn!), wenn Leute ihn nicht entschlüsseln konnten!
Es gibt viele Arten von Chiffren – einige verwenden Zahlen, andere Symbole, und die moderne Datenverschlüsselung nutzt sehr komplexe Algorithmen. Diese komplexen Algorithmen erfordern eine sehr komplexe Mathematik, daher können wir zunächst einige einfachere Algorithmen betrachten!
Monoalphabetische Chiffren
Schauen wir uns zuerst einige der einfachsten (und ältesten) Kodierungsmethoden an, die es gibt: monoalphabetische Chiffren.
„Monoalphabetisch“ klingt vielleicht nach einem schwierigen Wort, aber wir können es zerlegen: „mono“ bedeutet „eins“, und „alphabetisch“ bezieht sich auf das Alphabet.
Das heißt, bei monoalphabetischen Chiffren wird für die gesamte Nachricht ein einzelnes „Verschlüsselungsalphabet“ verwendet. Das bedeutet, dass jeder Buchstabe im ursprünglichen Text durchgehend in derselben verschlüsselten Nachricht immer mit demselben Buchstaben ersetzt wird.
Zum Beispiel: Wenn Sie festgelegt haben, dass A durch X ersetzt werden soll, dann werden alle A’s im Text zu X umgewandelt.
Caesar-Chiffre
Das klassische Beispiel für ein monoalphabetisches Chiffre ist das Caesar-Chiffre (benannt nach Julius Caesar). Dies ist im Grunde eine Regel, um „alle Buchstaben“ um eine bestimmte Anzahl von Positionen im Alphabet zu verschieben. Berichten zufolge verwendete Caesar selbst in seinen geheimen Nachrichten eine Verschiebung um 3 Buchstaben. Es funktioniert so, dass aus A ein D wird, aus B ein E, aus C ein F und so weiter durchs gesamte Alphabet. (Wenn man bei Z vorbeikommt, beginnt man wieder mit A.) Eine Nachricht wie ABC würde somit mithilfe der Methode Caesars zu DEF werden.
Niemand erwartet eine Nachricht im Cäsar-Chiffre?
So funktioniert das Cäsar-Chiffre in der Praxis:
- Wähle einen Schlüssel: Entscheide dich für eine geheime Zahl (zum Beispiel 3), die angibt, um wie viele Stellen jeder Buchstabe verschoben werden soll.
- Ersetze jeden Buchstaben: Für jeden Buchstaben in der ursprünglichen Nachricht finde den Buchstaben, der genau so viele Positionen nach ihm im Alphabet steht (bei einem Schlüssel von 3 wird A zu D, B zu E usw. – denke daran, bei Bedarf nach Z wieder auf A zurückzulaufen). Alternativ kannst auch Æ, Ø und Å einbeziehen, aber dies macht es etwas komplizierter.
- Verschlüsselte Nachricht: Ersetze die Buchstaben und schreibe die neue Nachricht mit den „verschobenen“ Buchstaben ab. Und schon hast du einen unlesbaren, geheimen Text, den nur diejenigen verstehen können, die über den Schlüssel verfügen!
- Um zu entschlüsseln (d. h., um ihn wieder in lesbaren Text umzuwandeln), wendet man einfach die entgegengesetzte Verschiebung an. Wenn du den Schlüssel kennst (z. B. 3), ist es ebenso leicht, die Nachricht zu lesen, indem du die Buchstaben 3 Schritte im Alphabet zurückschiebst.
Sicherheit?
Diese Codes sind langfristig nicht besonders sicher. Da das Muster (die Substitution) feststeht, kann eine Person mit genügend Geduld oder einigen cleveren Tricks die Geheimhaltung schnell aufdecken. Zum Beispiel gibt es im Caesar-Chiffre nur wenige mögliche Verschiebungen, genau so viele wie Buchstaben im Alphabet, sodass jeder alle ausprobieren kann, bis die Nachricht Sinn ergibt – oder sich anhand der Buchstabenhäufigkeiten herantasten kann. Mit anderen Worten: Vielleicht solltest du das Caesar-Chiffre nicht für hochgeheime Tagebuchnotizen oder Staatsgeheimnisse verwenden 😉.
Monoklavishe Chiffren sind eine großartige Möglichkeit, das Prinzip hinter der Verschlüsselung zu lernen. Sie sind einfach und zeigen, wie wir mit einer einfachen Regel (einem Schlüssel) einen verständlichen Text in etwas Mysteriöses und Unverständliches verwandeln können – und wieder zurück. Also, wenn du nächstes Mal einem Freund eine geheime Nachricht senden möchtest, kannst du das Caesar-Chiffre verwenden! Vielleicht könnt ihr euren eigenen Variation des geheimen Alphabets von Caesar erstellen? 🔐✨
Aufgaben
Programmiersprache?
Wie zuvor, verwende gerne jede beliebige Programmiersprache, die du möchtest! Die Beispiele hier werden in Python sein.
 Aufgabe 1.1 - Caesar-Chiffre-Verschlüsselung
Jetzt sollen wir tatsächlich etwas Code schreiben! Wir beginnen einfach mit der Erstellung der Verschlüsselung, basierend auf der Theorie sollte dies recht unkompliziert sein.
Implementieren Sie die Verschlüsselung mit dem Caesar-Chiffre, indem Sie eine Funktion verwenden, die Text und eine Zahl als “Schlüssel” entgegennimmt, also wie viel das Alphabet rotiert werden soll.
Tipps zur Vorgehensweise.
- Erstelle eine Funktion namens
caesar, die den zu verschlüsselnden Text und einen “shift” übernimmt, also wie viele Positionen im Alphabet der Text verschoben werden soll. - Gehe Buchstabe für Buchstabe durch den Text.
- Wir möchten keine anderen Zeichen als Buchstaben verschieben: Finde heraus, wie man überprüft, ob ein Zeichen im Text ein Buchstabe ist.
- Wir sollen den Buchstaben um n Stellen drehen, das heißt wir müssen die Rotation addieren: Finde heraus, wie du den Text in Zahlen umwandeln kannst, sodass du den Shift addieren kannst. Hinweis: Die
ord().Funktion. - Denke daran! Hier erhältst du verschiedene Werte, je nachdem, ob es kleine oder große Buchstaben sind. Verweise auf die ASCII-Tabelle.
- Sobald du einen Wert hast, besteht es einfach darin, den Wert von n einzufügen. Aber was passiert, wenn du am Ende des Alphabets bist? Wir bekommen nur Unsinn nach dem Buchstaben Z. Wie wird dies behoben? Dies erfordert etwas Nachdenken.
Behebe die Verschlüsselung.
Um die Verschlüsselung vollständig zu beheben, ist etwas Nachdenken erforderlich.
- Der erste Schritt zum Überlegen ist die Verwendung des Modulo-Operators,
%. - Da das Alphabet (auf Englisch) aus 26 Buchstaben besteht, können wir Modulo mit
26nehmen. - Aber das funktioniert nicht ganz, siehst du den Grund?
- Probiere, den Wert eines Zeichens mit
print()undord()auszugeben, was bekommst du? - Für
aerhältst du 97. Wenn du davon modulo 26 nimmst, ergibt sich 19. Denke daran, dass Modulo immer eine Antwort zwischen 0 und der Zahl gibt. - Dies kann behoben werden, indem man den Startwert für große und kleine Buchstaben speichert, diesen vom Buchstaben abzieht und dann modulo nimmt. Dann lautet es:
(ord(buchstabe) - ord('a')) % 26 - Um wieder den richtigen Buchstaben zu erhalten, fügst du einfach den Startwert erneut hinzu.
- Nachdem all dies erledigt wurde, kannst du endlich die Zahl wieder in einen Buchstaben umwandeln. Hier kannst du die Funktion
chr()verwenden. - Jetzt kannst du endlich den Buchstaben zu einem Ergebnis hinzufügen und den verschlüsselten Text zurückgeben!
Lösung:
def caesar_cipher(text, shift):
    result = ""
    for char in text:
        if char.isalpha():
        # Bestimme den Startposition basierend auf Groß- und Kleinbuchstaben
        start = ord('A') if char.isupper() else ord('a')
        # Die schwierige Verschieberechnung
        result += chr((ord(char) - start + shift) % 26 + start)
    else:
        result += char
    return result
 Aufgabe 1.2 - Caesar-Chiffre Entschlüsselung
Die Entschlüsselung besteht lediglich darin, die umgekehrte Berechnung der Verschlüsselung durchzuführen. Man subtrahiert den Offset-Wert anstatt ihn hinzuzufügen.
Tipps zur Vorgehensweise.
Verwende die Funktion aus Aufgabe 1 dafür. Nimm einfach dieselbe Funktion, aber umgekehrt. Das kannst du tun, indem du den Shift mit 26 - shift invertierst.
Lösung:
def caesar_decrypt(text, shift):
    return caesar_cipher(text, 26 - shift)
Andere Monoalphabetische Chiffren/Ciphers (z.B. Atbash)
Es gibt auch andere monoalphabetische Chiffren! Eine der einfacheren ist die sogenannte “Atbash”-Chiffre.
Wie funktioniert Atbash?
Diese ist sehr einfach, anstatt einer Rotation werden Buchstaben dem umgekehrten Alphabet zugeordnet. Hier ist eine Tabelle, die die Zuordnung zeigt:
| a | b | c | d | e | f | g | h | i | j | k | l | m | n | o | p | q | r | s | t | u | v | w | x | y | z |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| z | y | x | w | v | u | t | s | r | q | p | o | n | m | l | k | j | i | h | g | f | e | d | c | b | a |
Aufgabe 1.3 – Atbash-Chiffre Verschlüsselung und Entschlüsselung
Das Schöne an Atbach ist, dass die Verschlüsselung eine 1-zu-1-Transformation ist und daher direkt umgekehrt funktioniert. Das heißt, wenn Sie die Verschlüsselung erstellt haben, haben Sie automatisch auch die Entschlüsselung erstellt.
Wie kann dies in der Praxis umgesetzt werden?
Sie können entweder den Buchstaben relativ zu Z abziehen oder eine „Look-up“-Tabelle erstellen. Das bedeutet also, dass es sich um eine Tabelle oder ein Dictionary handelt, das alle Buchstaben von A bis Z und deren jeweilige Entsprechung enthält. Dies kann eine gute Lösung sein, wenn Sie einen anderen Typus der Verschlüsselung implementieren möchten.
Implementierung der Nachschlagetabelle.
letters = {
    'a': 'z'
    'b': 'y'
    'c': 'x'
    'd': 'w'
    # ... füge die restlichen Buchstaben weiter unten hinzu
}
Mit Hilfe dieser Tabelle können Sie Buchstabe für Buchstabe vorgehen, dann den Wert pro Buchstabe aus der Nachschlagetabelle abrufen und ihn ausgeben. Was müssen Sie für Groß- und Kleinbuchstaben tun?
Teil 2 – Kryptoanalyse von monoalphabetischen Chiffren
In diesem Abschnitt solltet ihr versuchen, einen Algorithmus zu erstellen, um ein Caesar-Chiffre „zu knacken“, also einen verschlüsselten Text zu nehmen und daraus ohne Kenntnis des Schlüssels den ursprünglichen Text zu gewinnen.
Dieses kann in gewisser Weise manuell erledigt werden, oder ihr könnt es auch mit einfacher „Cryptanalysis“ versuchen. Dies ist ein Konzept, das wir später genauer betrachten werden, aber für jetzt sehen wir uns nur eine der einfachsten Methoden an: Frequenzanalyse (frequency analysis). Ihr könnt mehr über dieses Konzept hier lesen: Frequenzanalyse oder hier Wikipedia - frequenzanalyse.
Diese Methode kann bei mehr als nur Caesar-Chiffren verwendet werden; sie lässt sich auch auf komplexere Algorithmen anwenden, aber da Caesar-Chiffre so einfach sind, ist die Frequenzanalyse darin trivial.
Wie funktioniert die Frequenzanalyse?
Die Frequenzanalyse ist, wie der Name vermuten lässt, eine Methode zur Überprüfung der Häufigkeit von Buchstaben in einem Text. Warum kann dies nützlich sein? Stellen Sie sich vor, Sie hätten einen langen Text – wir stellen uns hier einen englischen Text vor –, entnommen aus Wikipedia - frequency analysis:
In cryptanalysis, frequency analysis is the study of the frequency of letters or groups of letters in a ciphertext. The method is used as an aid to breaking classical ciphers.

Frequency analysis is based on the fact that, in any given stretch of written language, certain letters and combinations of letters occur with varying frequencies. Moreover, there is a characteristic distribution of letters that is roughly the same for almost all samples of that language. For instance, given a section of English language, E, T, A and O are the most common, while Z, Q, X and J are rare. Likewise, TH, ER, ON, and AN are the most common pairs of letters termed bigrams or digraphs), and SS, EE, TT, and FF are the most common repeats. The nonsense phrase ETAOIN SHRDLU represents the 12 most frequent letters in typical English language text.

In some ciphers, such properties of the natural language plaintext are preserved in the ciphertext, and these patterns have the potential to be exploited in a ciphertext-only attack.
Wenn wir diesen Text mit dem Cäsar-Chiffre verschlüsseln (und dabei Kommas, Leerzeichen und andere Sonderzeichen entfernen), erhalten wir folgenden Chiffer-Text:
xcrgneipcpanhxhugtfjtcrnpcpanhxhxhiwthijsnduiwtugtfjtcrnduatiitghdgvgdjehduatiitghxcprxewtgitmiiwtbtiwdsxhjhtsphpcpxsidqgtpzxcvraphhxrparxewtghugtfjtcrnpcpanhxhxhqphtsdciwtupriiwpixcpcnvxktchigtirwdulgxiitcapcvjpvtrtgipxcatiitghpcsrdbqxcpixdchduatiitghdrrjglxiwkpgnxcvugtfjtcrxthbdgtdktgiwtgtxhprwpgpritgxhixrsxhigxqjixdcduatiitghiwpixhgdjvwaniwthpbtudgpabdhipaahpbeathduiwpiapcvjpvtudgxchipcrtvxktcphtrixdcdutcvaxhwapcvjpvttippcsdpgtiwtbdhirdbbdclwxatofmpcsypgtgpgtaxztlxhtiwtgdcpcspcpgtiwtbdhirdbbdcepxghduatiitghitgbtsqxvgpbhdgsxvgpewhpcshhttiipcsuupgtiwtbdhirdbbdcgtetpihiwtcdchtchtewgphttipdxchwgsajgtegthtcihiwtbdhiugtfjtciatiitghxcinexrpatcvaxhwapcvjpvtitmixchdbtrxewtghhjrwegdetgixthduiwtcpijgpaapcvjpvteapxcitmipgtegthtgktsxciwtrxewtgitmipcsiwthtepiitgchwpktiwteditcixpaidqttmeadxitsxcprxewtgitmidcanpiiprz
Dieser Text sieht zwar unmöglich zu “cracken” aus, aber mithilfe der “Frequenzanalyse” ist es nicht nur möglich, sondern sogar einfach.
Betrachten Sie die folgende Abbildung:
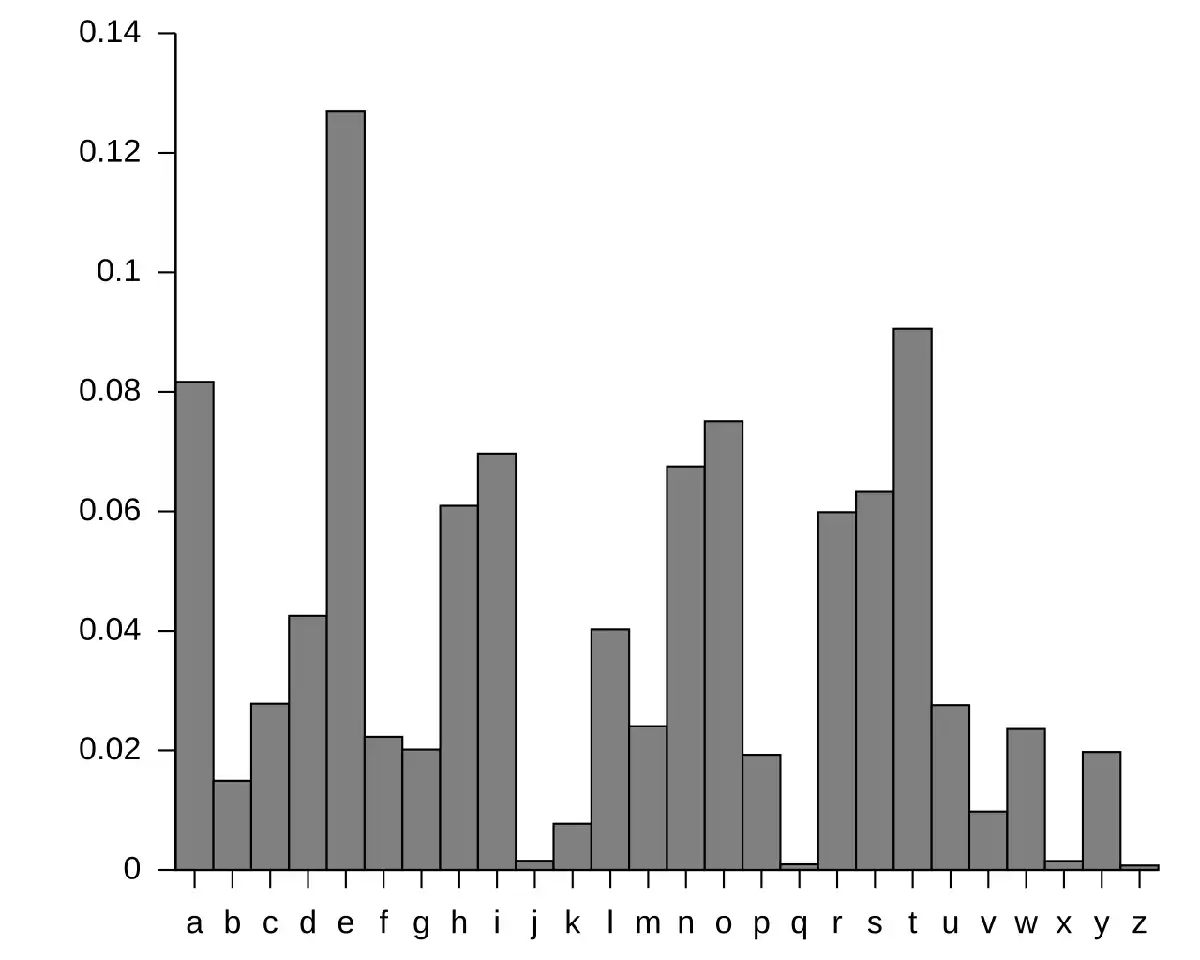
Dies ist eine Figur, die die Verteilung von Buchstaben im Englischen zeigt. Man kann sehen, dass der Buchstabe E am häufigsten vorkommt, gefolgt von T, A und O.
Diese lässt sich in eine Tabelle umwandeln und wird dann verwendet, um einen gegebenen Chiffer-Text zu zählen und zu analysieren, um ihn anschließend zu “cracken”. In den folgenden Aufgaben sollen Sie ein Programm erstellen, das Cäsar-Chiffren eigenständig knacken kann. Es stimmt, dass das Cäsar-Chiffre so einfach ist, dass man alle 26 Möglichkeiten manuell prüfen könnte, aber hier werden wir die Lösung vollständig automatisch ermitteln.
Aufgabe 2.1 – Erstellung einer Häufigkeitstabelle
Erstelle in einer Python-Datei eine Häufigkeitstabelle der Buchstaben der englischen Sprache. Du kannst versuchen, diese selbst zu finden, aber wenn dir das zu viel Aufwand macht, verstehen wir das!
Wenn du sie unbedingt selbst finden möchtest, kannst du vorgehen wie bei Aufgabe 2.2, jedoch mit einem sehr großen Text.
English Letter Frequency (Svaret)
english_letter_frequency = {
    'E': 12.70,
    'T': 9.06,
    'A': 8.17,
    'O': 7.51,
    'I': 6.97,
    'N': 6.75,
    'S': 6.33,
    'H': 6.09,
    'R': 5.99,
    'D': 4.25,
    'L': 4.03,
    'C': 2.78,
    'U': 2.76,
    'M': 2.41,
    'W': 2.36,
    'F': 2.23,
    'G': 2.02,
    'Y': 1.97,
    'P': 1.93,
    'B': 1.29,
    'V': 0.98,
    'K': 0.77,
    'J': 0.15,
    'X': 0.15,
    'Q': 0.10,
    'Z': 0.07
}
Aufgabe 2.2 - Zählen der Häufigkeit von Buchstaben in Text
Nun wollen wir einen Algorithmus erstellen, der die Häufigkeit von Buchstaben in einem gegebenen Text ermittelt.
Tipps zur Vorgehensweise
- Beginne mit einer Funktion, die einen Text annimmt (kann alles sein).
- Erstelle in der Funktion ein “dictionary” (Python Dictionaries), mit Einträgen für jeden Buchstaben des Alphabets, gesetzt auf
0. ({'A' = 0, 'B' = 0, 'C' = 0, ..., 'Z' = 0}) - Gehe den gesamten Text durch und zähle jeden einzelnen Buchstaben (erhöhe den entsprechenden Eintrag im dictionary um 1). Hier solltest du wahrscheinlich Zeichen ignorieren, die keine Buchstaben sind, beachte auch Groß- und Kleinschreibung.
- Halte fest, wie viele Buchstaben insgesamt gezählt wurden.
- Wenn du fertig mit dem Zählen bist, teile
/jeden Wert in der Tabelle durch die Länge des Textes und multipliziere dann mit 100, dies ergibt eine Prozentfrequenz. (Du kannst deine Tabelle natürlich auch zwischen 0 und 1 belassen.) - Jetzt solltest du eine Frequenztabelle für den Text haben.
Aufgabe 2.3 – Die Frequenz eines Texts mit der echten Frequenz vergleichen
Wenn Sie die Frequenzen aller Buchstaben im Text ermittelt haben, können Sie eine Funktion erstellen, die den „Abstand“ berechnet. Was? Was bedeutet das?!
Sie können sich vorstellen, dass die Frequenz von beispielsweise dem Buchstaben E im Text eine Zahl sein wird. Sie können den „Abstand“ zwischen dieser und der tatsächlichen Frequenz berechnen, die 12.70 beträgt. Beispiel: Die Frequenz ist 9.63, was ist der Abstand? Der Abstand wird der absolute Wert (Negative Zahlen werden positiv) zwischen diesen beiden Werten sein: \(12.70 - 9.63 = 3.07\).
Erstellen Sie eine Funktion, die jeden Buchstaben durchläuft und den Abstand findet. Addieren Sie anschließend alle Abstände zu einem „Gesamt“-Abstand zusammen.
Mathefunktion?
Wenn Sie sich fragen, wie die Mathefunktion dafür aussieht, so sieht sie so aus:
\(\sum_{n=0}^{N} \lvert a - b\rvert\)
Tipps zur Vorgehensweise
- Verwende eine
for-Schleife, um die gesamte Häufigkeitstabelle durchzugehen. - Für jeden Buchstaben in der Häufigkeitsstelle bestimme den Absolutwert im Vergleich zu der tatsächlichen Frequenz. Verwende dafür die Funktion
abs()in Python. - Addiere alle Werte zusammen, dann erhältst du ein Endergebnis.
 Aufgabe 2.4 – „Brich“ die Caesar-Chiffre
Jetzt setzen wir endlich alles zusammen, was wir bisher gemacht haben! Jetzt werden wir eine Caesar-Chiffre „brechen“.
Erstelle ein Programm, das eine Caesar-Chiffre „bricht“! Ohne Benutzereingabe sollst du einen verschlüsselten Text eingeben und den entschlüsselten Text erhalten können, ohne dass du einen Schlüssel benötigst.
Testdaten
Hier sind einige Testdaten, die ihr verwenden könntet. Was sagt ihr dazu?
| Testdaten |
|---|
cqrbvnbbjpnrbjenahbnlancxwnqxynoduuhhxdjanjkuncxmnlxmnrclxvyuncnuhjwmqnanjanbxvnfxamboaxvxdaojexarcnsnmrqnuuxcqnanrcbxenajwjtrwrqjencqnqrpqpaxdwmhxdfnanarpqccqnwnpxcrjcrxwbfnanbqxac |
lsaizivxlmwqiwwekimwuymxiwlsvxwsmxqmklxrsxasvoewibtigxihlsaizivmjmxhsiwksshnsf |
bmtxymjwjsfdfsxbjwrjxyfsifsizsktqidtzwxjqkqtslqnajymjpnslgfwsfwitmjdtzhtrjrtxyhfwjkzqqdzutsdtzwmtzwynxstbxywzhpybjqajljyymjjytgjikwfshnxhtktwymnxwjqnjkrzhmymfspxynxgnyyjwhtqifsinfrxnhpfymjfwymfajdtzmfivznjylzfwistyfrtzxjxynwwnslbjqqlttisnlmynkdtzitrjjymtwfyntfsirfwhjqqzxymjwnafqxtkrdbfyhmgniymjrrfpjmfxyj |
zwkyvivrivrepzuzfkjzekyviffdnzcckyvpgcvrjvjkreulgjrzukyvjritrjkztkvrtyvirwkvircfexjzcvetvfevwivjydreifjvkfyzjwvvkefnkyvedzjkvinypufpfltfejzuvipflijvcwrezuzfkzehlzivukyvkvrtyvinzkyrjevvinvccrtklrccpzufekjrzukyvjkluvekslkzyrkvkfjvvpfljkreuzexlgkyvivrccsppflijvcw |
uwwilxchaniuffehiqhfuqmizupcuncihnbylycmhiqusuvyymbiofxvyuvfynizfscnmqchamulyniimguffniayncnmzunfcnnfyvixsizznbyaliohxnbyvyyizwiolmyzfcymuhsqusvywuomyvyymxihnwulyqbunboguhmnbchecmcgjimmcvfysyffiqvfuwesyffiqvfuwesyffiqvfuwesyffiqvfuweiibvfuweuhxsyffiqfynmmbueycnojufcnnfyvullsvlyuezumncmlyuxswigcha |
Tipps zur Vorgehensweise
- Beginne damit, eine Funktion zu erstellen, die Text als Parameter entgegennimmt.
- Verwende die Dekodierfunktion für Caesar-Chiffren mit Rotation N auf dem Text; N beginnt bei 0.
- Erstelle eine Häufigkeitstabelle des Ergebnisses.
- Bestimme die Abweichung zwischen dem Ergebnis und der tatsächlichen Häufigkeitsverteilung.
- Entweder: a) Halte die Abweichungen in einer Liste fest oder b) halte den minimalen Wert sowie die dazugehörige Rotation fest (dies wird der Schlüssel sein).
- Erhöhe die Rotation um 1 und wiederhole Schritte 2 bis 6, bis N den Wert 26 erreicht (volle Rotation).
- Gib den dekodierten Text zurück, da die minimale Abweichung zum richtigen Schlüssel führt.